Una aplicación puede responder correctamente durante las pruebas y presentar fallas cuando comienza a recibir tráfico real. El aumento de solicitudes, una consulta lenta a la base de datos o un servicio externo que deja de responder pueden afectar la experiencia del usuario sin que exista una interrupción completa del sistema. En estas situaciones, revisar únicamente el consumo de CPU o memoria resulta insuficiente para identificar el origen del problema.
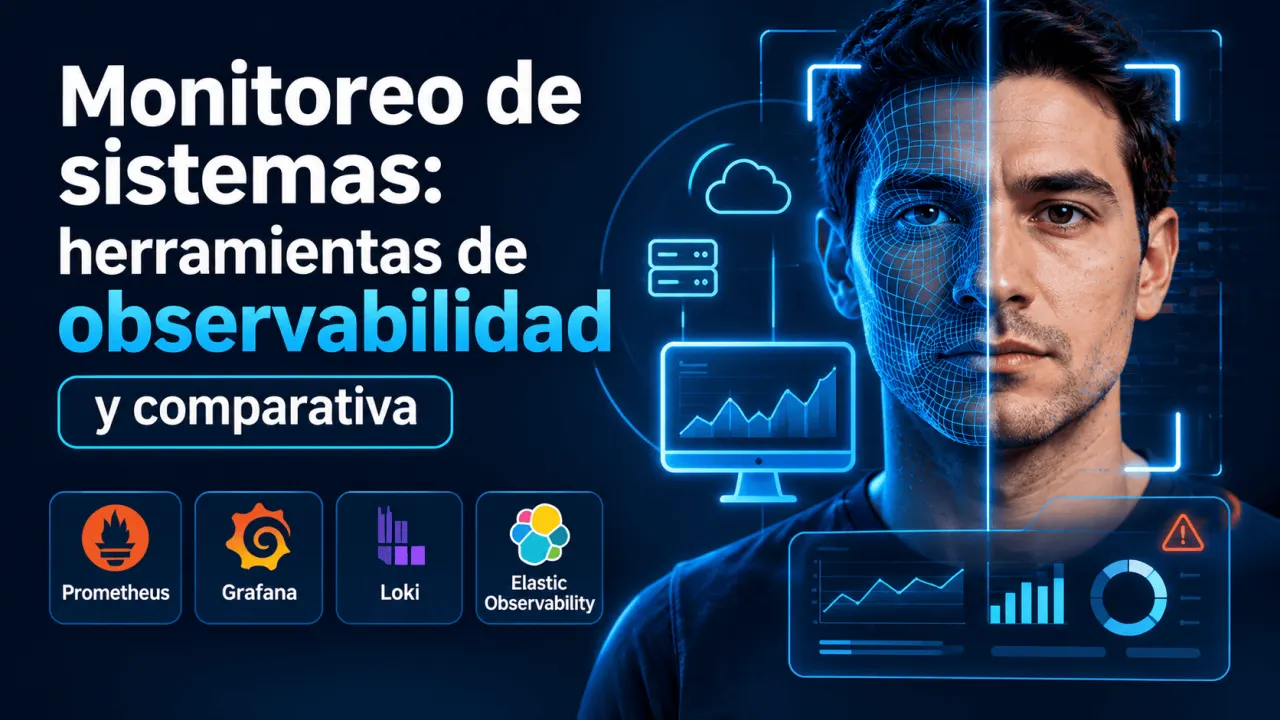
El monitoreo de sistemas con herramientas de observabilidad permite analizar el comportamiento de aplicaciones, servidores y servicios mediante métricas, registros de eventos y trazas distribuidas. Comprender cómo funcionan estas señales y comparar las herramientas disponibles ayuda a diseñar una estrategia de supervisión adaptada a las necesidades técnicas de cada organización.
Qué es la observabilidad de sistemas
La observabilidad es la capacidad de comprender el estado interno de un sistema a partir de los datos que genera durante su funcionamiento. Según la documentación oficial de OpenTelemetry sobre observabilidad, un sistema adecuadamente instrumentado permite investigar comportamientos inesperados utilizando información recopilada previamente.
Aunque monitoreo y observabilidad están relacionados, cumplen funciones diferentes. El monitoreo comprueba condiciones previamente definidas, como una utilización elevada de memoria. La observabilidad permite profundizar en las causas de un comportamiento, incluso cuando el equipo técnico no había previsto ese escenario.
| Criterio | Monitoreo tradicional | Observabilidad |
|---|---|---|
| Pregunta principal | ¿Existe alguna condición anormal? | ¿Por qué ocurre el comportamiento observado? |
| Información habitual | Indicadores, estados y umbrales | Métricas, logs, trazas y contexto técnico |
| Aplicación principal | Detectar condiciones conocidas | Investigar fallas conocidas o inesperadas |
| Ejemplo | Alertar cuando aumenta la latencia | Identificar qué servicio o consulta provoca la latencia |
Ambos enfoques son complementarios. Una plataforma de observabilidad puede incorporar las mismas reglas y alertas utilizadas en el monitoreo tradicional, ampliando la capacidad de diagnóstico mediante información contextual.
Las tres señales fundamentales
La observabilidad de aplicaciones suele organizarse alrededor de tres señales de telemetría: métricas, logs y trazas. Cada una describe una dimensión diferente del funcionamiento del sistema, tal como establece la documentación de señales de OpenTelemetry.
Por ejemplo, si una plataforma de comercio electrónico comienza a responder lentamente, una métrica puede revelar el incremento de latencia. La traza de una solicitud permite identificar una operación demorada en el servicio de inventario, mientras que los logs pueden mostrar un error de conexión a la base de datos. Para relacionar esas señales, es necesario conservar identificadores y atributos de contexto consistentes.
Herramientas de observabilidad más utilizadas
El ecosistema de observabilidad incluye soluciones especializadas y plataformas integradas. Algunas están orientadas a recopilar métricas o almacenar logs, mientras que otras permiten analizar múltiples señales desde un entorno centralizado.
Prometheus recopila y almacena métricas como series temporales. Utiliza PromQL para realizar consultas y admite reglas de alertas. Su arquitectura resulta especialmente útil en entornos dinámicos donde los servicios pueden aparecer o desaparecer durante la operación, según su documentación técnica oficial.
Grafana permite construir paneles que consultan distintas fuentes de datos. Puede utilizarse con Prometheus para visualizar métricas y con otros sistemas para explorar registros o trazas. Los paneles requieren fuentes configuradas y consultas adecuadas, como explica la guía oficial de dashboards de Grafana.
Grafana Loki se especializa en la agregación y consulta de logs. Su diseño indexa principalmente etiquetas en lugar del contenido completo de cada registro, lo que influye en su estrategia de almacenamiento y búsqueda.
Elastic Observability integra análisis de logs, métricas y trazas, además de funciones de monitoreo de infraestructura y rendimiento de aplicaciones. Su enfoque facilita consultar información de distintos componentes mediante capacidades de búsqueda y análisis.
Comparativa de herramientas
La elección depende de los datos que necesita analizar el equipo, el presupuesto operativo, la infraestructura existente y las capacidades de administración. La siguiente tabla resume funciones principales de cuatro herramientas, a partir de sus características documentadas.
| Herramienta | Función principal | Ventaja técnica | Consideración |
|---|---|---|---|
| Prometheus | Métricas y alertas | Consultas PromQL y descubrimiento de servicios | No sustituye un sistema dedicado de logs o trazas |
| Grafana | Visualización y análisis | Paneles con múltiples fuentes de datos | Requiere fuentes de telemetría conectadas |
| Grafana Loki | Agregación de logs | Indexación basada en etiquetas | La selección de etiquetas afecta las consultas y el rendimiento |
| Elastic Observability | Observabilidad integrada | Análisis de logs, métricas y trazas | Evaluar recursos, almacenamiento y condiciones de uso |
Esta comparación describe capacidades, no establece un ranking absoluto. Prometheus, Grafana y Loki pueden emplearse conjuntamente, mientras que Elastic Observability ofrece un enfoque integrado. Las arquitecturas, los costos y las capacidades concretas dependen del despliegue y de los servicios seleccionados. Para revisar los alcances de las dos alternativas de almacenamiento, pueden consultarse la documentación oficial de Loki y la descripción técnica de Elastic Observability.
Cómo implementar el monitoreo
Una implementación efectiva comienza identificando los servicios críticos y definiendo qué comportamientos necesitan supervisión. Instalar herramientas sin establecer objetivos puede generar grandes volúmenes de información con escasa utilidad operativa.
Una configuración inicial podría combinar Prometheus para recopilar métricas y Grafana para visualizarlas. Si posteriormente se necesita analizar errores en detalle, puede incorporarse Loki. Para investigar solicitudes entre microservicios será necesario añadir instrumentación de trazas y un sistema capaz de recibirlas y consultarlas.
Indicadores para evaluar la confiabilidad
Recopilar telemetría es solo una parte del trabajo. También es necesario establecer qué condiciones representan un servicio aceptable para los usuarios. La ingeniería de confiabilidad de sitios utiliza indicadores de nivel de servicio (SLI) y objetivos de nivel de servicio (SLO) para relacionar mediciones técnicas con expectativas operativas.
Por ejemplo, un equipo puede definir como SLI el porcentaje de solicitudes válidas que finalizan correctamente y establecer un SLO para un periodo de evaluación. Otro indicador puede medir la proporción de respuestas que se completan dentro de un umbral de latencia. Estas definiciones deben especificar qué solicitudes se incluyen, cómo se consideran los errores y cuál es la ventana de medición.
El capítulo Service Level Objectives del libro Site Reliability Engineering de Google explica cómo utilizar estos conceptos para seleccionar mediciones vinculadas a la calidad del servicio. Un objetivo bien definido permite distinguir una variación técnica normal de una situación que afecta realmente al usuario.
Errores y limitaciones frecuentes
Uno de los errores habituales es recopilar toda la información disponible sin considerar su utilidad. Los registros excesivos incrementan el almacenamiento y dificultan las búsquedas; las etiquetas de alta cardinalidad pueden elevar el consumo de recursos en sistemas de métricas. También existe el riesgo de incluir datos sensibles en los logs si no se aplican controles de filtrado y acceso.
Otro problema aparece cuando las alertas se basan únicamente en umbrales de infraestructura. Un incremento de CPU no siempre requiere intervención inmediata, mientras que un servicio puede experimentar errores aunque sus recursos permanezcan dentro de valores habituales. Por ello, las alertas deben considerar síntomas relevantes para el funcionamiento del servicio y contar con procedimientos de respuesta definidos.
La retención de datos, el muestreo de trazas, las restricciones de acceso y la disponibilidad de la propia infraestructura de observabilidad también requieren planificación. Ninguna herramienta garantiza por sí sola la identificación automática de todas las causas de una incidencia.
Conclusión
El monitoreo con herramientas de observabilidad permite pasar de la simple detección de anomalías a una investigación técnica más completa del comportamiento de los sistemas. La elección entre herramientas especializadas o plataformas integradas debe basarse en los servicios críticos, las señales necesarias y la capacidad del equipo para administrar la solución. Una implementación gradual, con indicadores definidos y procedimientos de respuesta, ofrece una base verificable para gestionar la confiabilidad de las aplicaciones.
Respalda la formación técnica de tu organización
Si tu organización ya imparte capacitaciones sobre monitoreo, DevOps u observabilidad, el Instituto Internacional de Ingeniería (3i) ofrece opciones para respaldar programas y emitir certificados verificables a los participantes, sujetas a evaluación y condiciones de la plataforma.
Fuentes consultadas
OpenTelemetry. Observability primer. Documentación oficial sobre los fundamentos de la observabilidad y la instrumentación de aplicaciones.
Prometheus. Overview. Documentación oficial de arquitectura, recopilación de métricas, consultas y alertas.
Grafana Labs. Create dashboards. Documentación oficial de paneles, visualizaciones y fuentes de datos.
Grafana Labs. Loki overview. Documentación técnica sobre recopilación, indexación, almacenamiento y consulta de logs.
Elastic. Elastic Observability solution overview. Documentación oficial sobre análisis de logs, métricas, trazas y monitoreo de aplicaciones.
Google. Service Level Objectives, Site Reliability Engineering. 2016. Capítulo sobre indicadores, objetivos y evaluación de la confiabilidad de los servicios.